배경과 목표
어떤 문제에서 시작했나요?
공공 건설 입찰에서는 같은 공사라도 참여 업체들이 써 내는 사정률의 분포에 따라 낙찰 여부가 갈립니다. 고객사의 입찰 담당자는 공고번호를 넣어 성격이 비슷한 공고를 여섯 건쯤 추려 낸 뒤, 그 공고들의 참여 업체 평균과 예정가격 분포를 직접 겹쳐 보며 써 낼 구간을 골라 왔습니다. 전달받은 업무 절차 메모에는 투찰 패턴이 일정한 업체를 먼저 걸러 내고 남은 구간을 분석하고 싶지만, 사람이 업체를 하나하나 확인하기에는 시간이 너무 오래 걸린다는 내용이 적혀 있었습니다. 판단의 근거가 담당자 한 사람의 경험과 그날 들여다본 공고 몇 건에 묶여 있다는 점이 이 업무의 출발점이었습니다.
목표: 합의된 범위는 기존 입찰·낙찰 공고와 참여 업체 데이터를 학습한 딥러닝 모델을 만들고, 공고번호 하나로 그 모델의 예측 사정률과 예측 금액을 확인할 수 있는 웹 화면을 붙이는 것이었습니다. 완료 기준은 모델의 오차를 수치로 평가하는 데서 그치지 않고, 실제 공고번호를 기준으로 시뮬레이션해 예측값이 상위 참여 업체 대비 어느 정도 위치에 오는지를 기록하는 것까지였습니다. 낙찰률이나 수주 금액 같은 운영 성과는 합의 범위에 들어 있지 않았습니다.
네오렉트의 역할
어디까지 수행했나요?
네오렉트는 입찰·낙찰·참여 업체 데이터 수집과 정제, 학습용·테스트용 데이터셋 구성, 딥러닝 모델 설계와 학습, 성능 평가와 파라미터 조정, 그리고 예측 결과를 보여 주는 클라이언트 웹과 모델 API 서버·데이터베이스 구축을 맡았습니다. 입찰 실무에서 무엇을 보고 구간을 고르는지에 대한 기준은 고객사가 전달한 업무 절차 설명을 근거로 삼았습니다. 데이터는 고객사가 이용하던 외부 입찰 정보 서비스에서 수집했습니다.
주요 기능
무엇을 만들었나요?
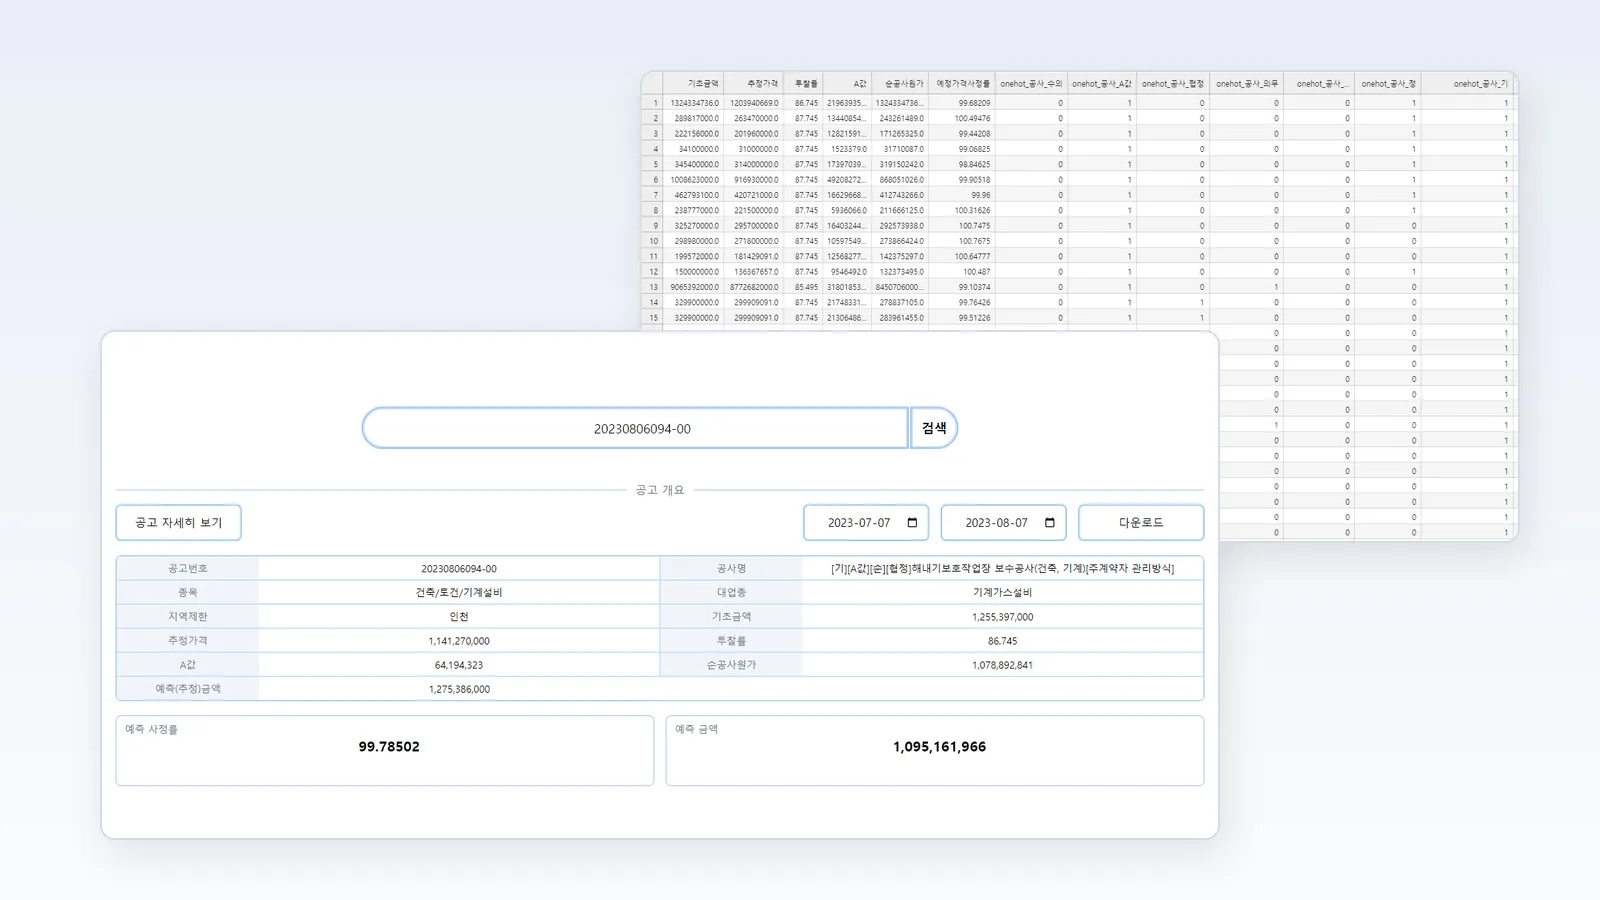
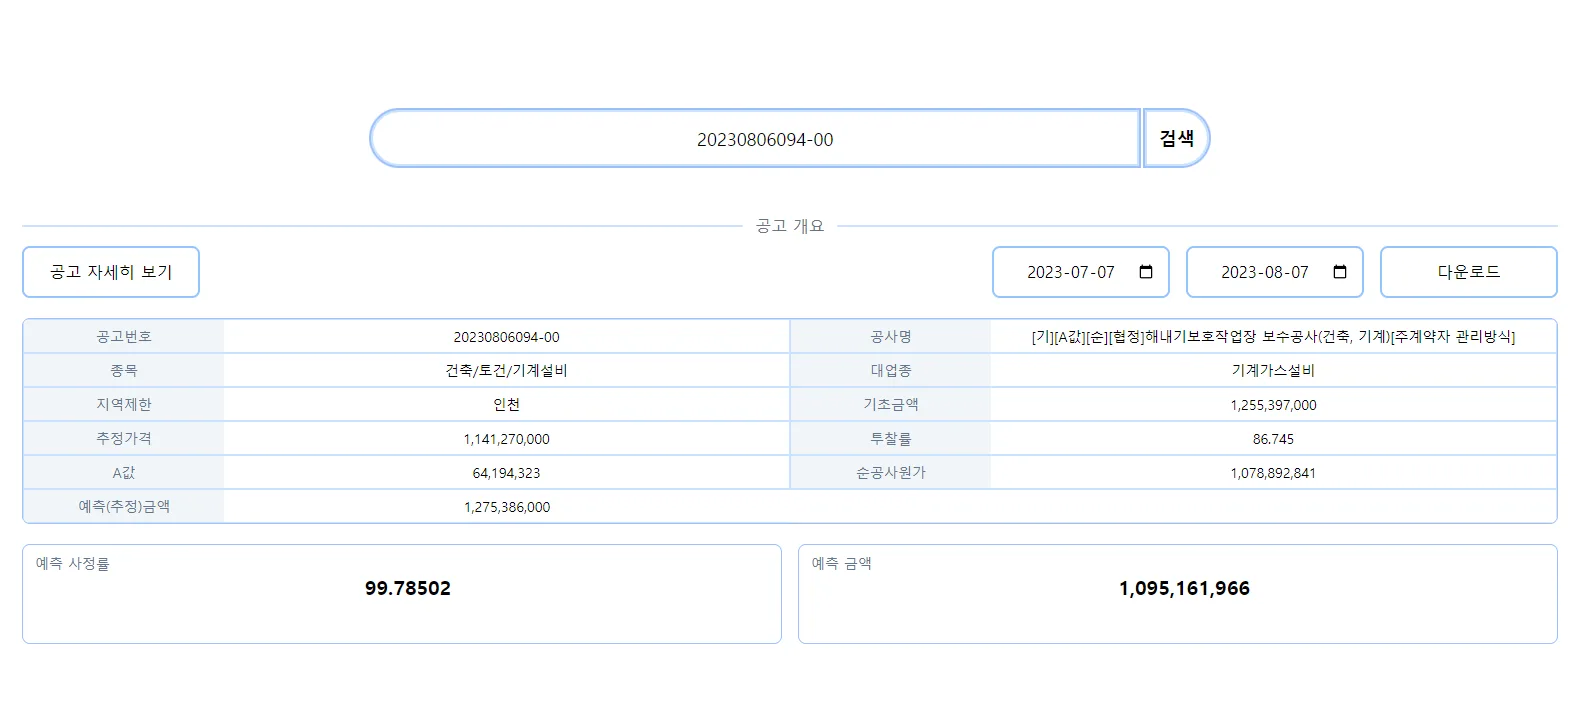
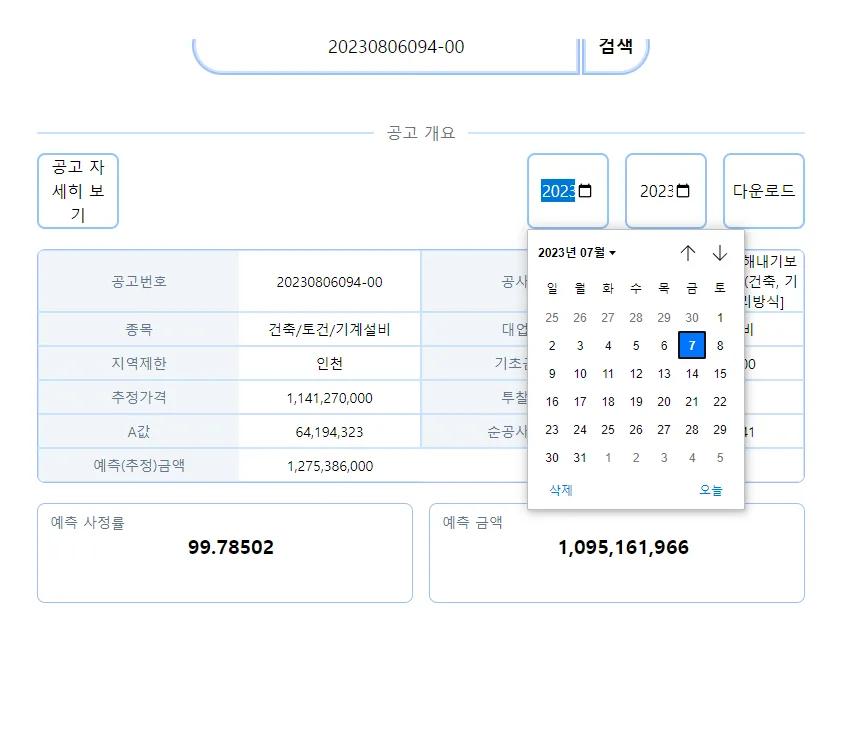
- 공고번호 검색 — 담당자가 입찰 공고번호를 입력하면 해당 공고의 종목·대업종·지역 제한·기초금액·추정가격·A값·순공사원가를 자동으로 불러와 한 화면에 정리합니다.
- 사정률·금액 예측 — 불러온 공고 정보를 학습된 모델에 넣어 예측 사정률과 그 값으로 계산한 예측 금액을 함께 표시합니다.
- 공고 원문 확인 — 화면에서 바로 해당 공고번호의 입찰 정보 원문으로 이동해 세부 조건과 일정을 확인할 수 있습니다.
- 기간별 낙찰정보 내려받기 — 시작일과 종료일을 고르면 그 기간의 낙찰 정보와 기업별 입찰 정보를 엑셀 파일로 받습니다.
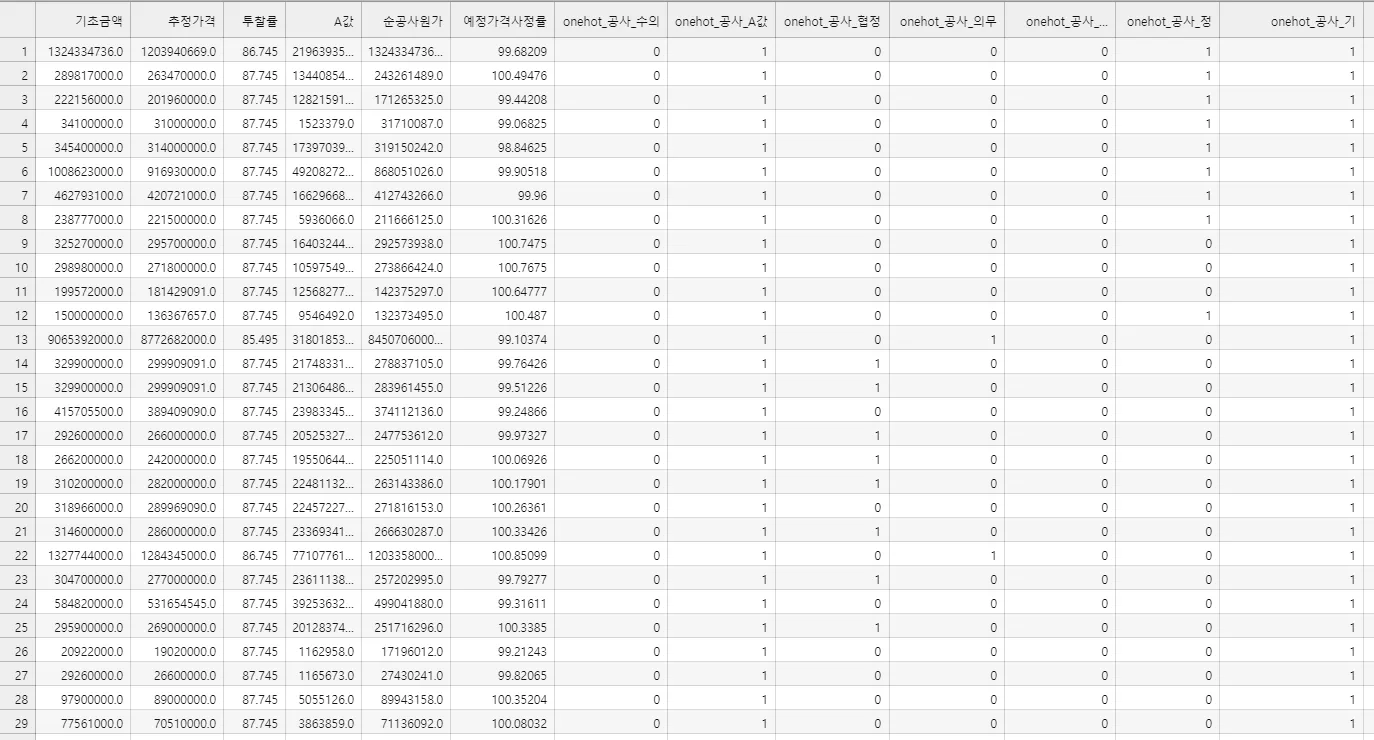
- 데이터 수집·정제 — 입찰 정보, 낙찰 정보, 참여 업체 목록에서 필요한 항목만 뽑아 정형화하고, 공사명·종목 같은 문자열 항목은 패턴별로 분류해 학습에 쓸 수 있는 형태로 정리합니다.
- 모델 서버 모듈 분리 — API·Train·Config·DataAdd 네 모듈로 나눠 예측 요청 처리와 재학습, 데이터 추가를 따로 운영합니다.
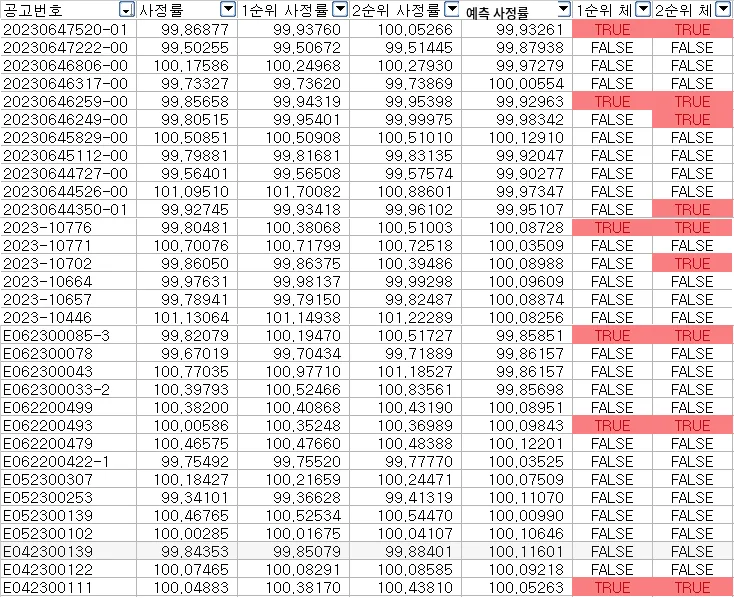
- 시뮬레이션 평가 — 실제 공고번호를 기준으로 예측 사정률이 1순위·2순위 참여 업체의 사정률보다 유리한 쪽에 들어가는지를 공고마다 판정해 비율을 기록합니다.
해결 과정
제약을 어떻게 풀었나요?
제약 1
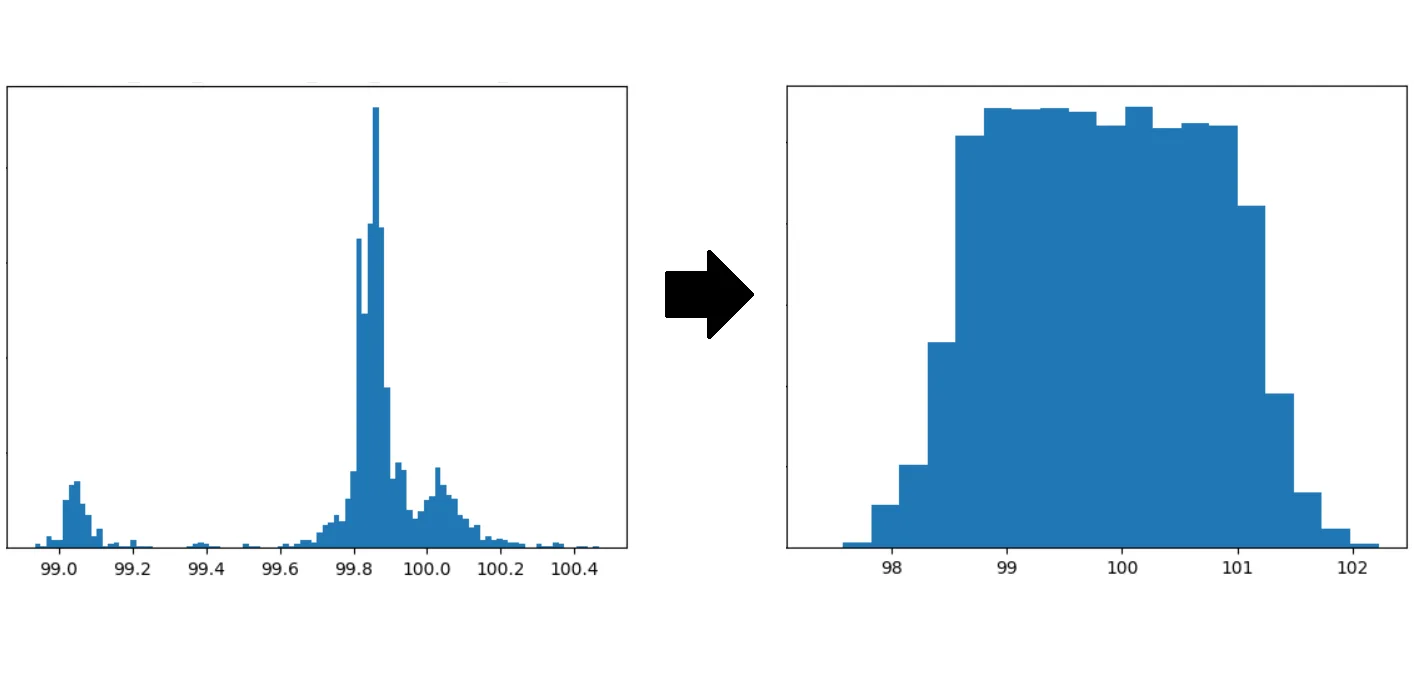
학습 데이터의 정답에 해당하는 사정률이 특정 구간에 몰려 있어, 초기 모델이 서로 다른 공고에 대해 거의 같은 사정률을 내놓았습니다.
의사결정: 평균오차 수치만 보면 초기 모델이 더 좋았지만, 어떤 공고를 넣어도 비슷한 값이 나오는 모델은 실무에서 쓸 수 없다고 보고 평균오차를 조금 손해 보더라도 예측값의 분포를 넓히는 쪽을 택했습니다.
구현: 데이터가 몰려 있는 구간을 절삭해 다시 학습시켰습니다. 그 결과 평균오차는 0.4834에서 0.5478로 올랐지만 최대오차가 3.46에서 2.23으로 줄었고, 오차 3% 이하 비율이 99.94%에서 100%가 됐습니다(내부 평가 데이터셋 기준).
제약 2
공고 데이터에는 공사명·종목·대업종 같은 문자열과 기초금액·추정가격 같은 숫자가 섞여 있었습니다.
의사결정: 숫자 항목은 단위가 큰 값에 로그를 씌우는 방식도 시험했으나 결과에 의미 있는 차이가 없어 원래 값을 그대로 쓰기로 했고, 문자열 항목은 값들이 일정한 패턴으로 나뉜다고 보고 패턴별 분류를 거쳐 학습에 넣기로 했습니다.
구현: 공고번호처럼 그 자체로 의미를 갖지 않는다고 본 항목은 분석에서 제외하고 결과 표시용으로만 남겼고, 1만 건 중 한두 건뿐인 희귀 조합은 학습에서 뺐습니다.
제약 3
오차 지표만으로는 이 모델을 실제 입찰 판단에 써도 되는지 가늠하기 어려웠습니다.
의사결정: 데이터셋 기준 평가와 별개로, 실제 공고번호를 기준으로 예측값이 상위 참여 업체보다 유리한 쪽에 들어가는 비율을 세어 보기로 했습니다.
구현: 수집한 공고 7,762건 중 중복이거나 사정률·순위 값이 빠진 3,550건을 제외한 4,212건으로 추론해, 1순위보다 낮은 사정률 164건(3.89%)과 2순위보다 낮은 사정률 283건(6.71%)을 기록했습니다.
결과
무엇이 달라졌나요?
- 구축·납품 범위
- 클라이언트 웹 · 딥러닝 모델 API 서버 · 데이터베이스
- 근거: 개발 결과보고서의 시스템 구성 항목
- 최종 모델 오차 3% 이하 비율
- 100% (평균오차 0.5478 · 최대오차 2.23, 내부 평가 데이터셋 기준)
- 근거: 개발 결과보고서의 모델 결과값 기록
- 시뮬레이션 평가 공고 수
- 4,212건 (수집 7,762건 중 중복·결측 3,550건 제외)
- 근거: 개발 결과보고서의 모델 실제 시뮬레이션 기록
화면
실제 화면과 구조
사용 기술
발행 2026.11.10
함께 보면 좋은 콘텐츠
비슷한 프로젝트를 준비 중이신가요?
배경과 제약 조건을 알려주시면 이 사례의 경험을 바탕으로 진행 방식과 예상 범위를 제안드립니다.